Elastic Search 기초
Elasticsearch란?
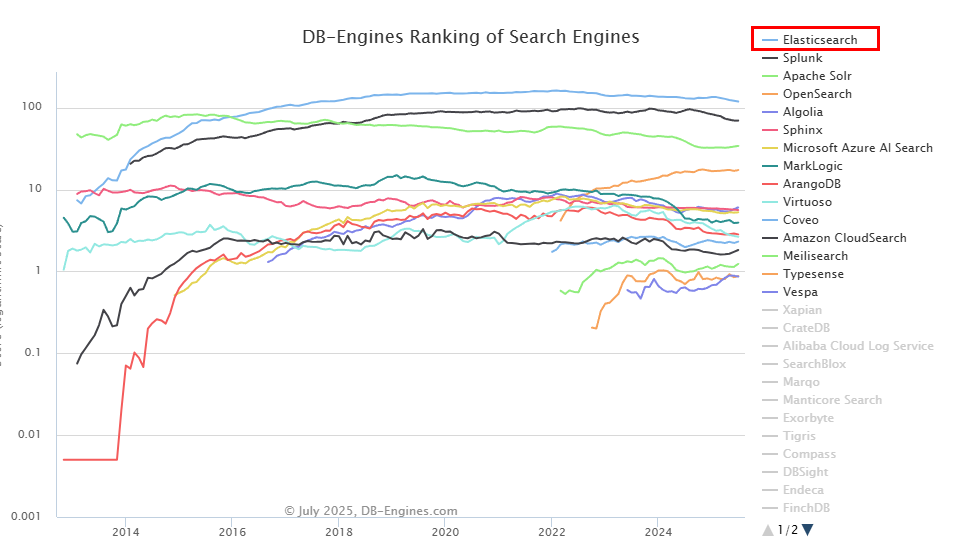
Elasticsearch(https://www.elastic.co/elasticsearch)는 Apache Lucene 기반의 분산 검색 및 분석 엔진입니다. 대용량의 데이터를 실시간으로 저장, 검색, 분석할 수 있는 오픈소스 NoSQL로, 특히 Full-text Search에 특화되어 있습니다. 검색 엔진 순위를 보면 2016년부터 현재 가장 많이 사용되고 있습니다.
장점
1. 강력한 full text search
역색인(Inverted Index) 구조를 사용하여 텍스트 검색에 최적화되어 있습니다.
일반 DB 검색
1
2
3
4
SELECT * FROM products WHERE name ILIKE '%아이폰%';
-- 결과: "아이폰 15 프로" (찾음)
-- 결과: "iPhone 15 Pro" (못 찾음!)
-- 결과: "애플 스마트폰" (못 찾음!)
Elasticsearch 검색
1
2
3
4
5
6
7
8
9
10
11
12
13
GET products/_search
{
  "query": {
    "match": {
      "name": "아이폰"
    }
  }
}

# 결과: "아이폰 15 프로" ✅
# 결과: "iPhone 15 Pro" ✅ (synonyms 설정 시)
# 결과: "애플 스마트폰" ✅ (synonyms 설정 시)
# synonyms 설정 시 모든 관련 상품 검색 가능!
핵심 차이점
- RDB: 정확히 일치하는 글자만 찾음 (패턴 매칭)
- ES: 의미가 비슷한 내용도 찾음 (지능적 검색)
역색인(Inverted Index) 동작 원리 역색인이란 일반 색인과 반대로, 단어를 키로 하여 해당 단어가 포함된 문서를 찾는 구조입니다.
1
2
3
4
5
6
7
8
상품1: "삼성 갤럭시 S24"
상품2: "아이폰 15 프로"
상품3: "갤럭시 버즈"

→ 역색인 테이블
"삼성"    → [상품1]
"갤럭시"  → [상품1, 상품3]
"아이폰"  → [상품2]
“갤럭시” 검색 시 즉시 [상품1, 상품3] 반환. 모든 문서를 스캔할 필요가 없어 빠른 검색이 가능합니다.
해당 기능이 가능한 이유?
- 토크나이징: 문장을 단어로 분리 (“아이폰 15 프로” → [“아이폰”, “15”, “프로”])
- 정규화: 대소문자 통일, 특수문자 제거 (“iPhone-15” → “iphone15”)
- 형태소 분석: 언어별 분석기로 의미 단위 추출 (“스마트폰들” → [“스마트폰”, “들”])
- 동의어 처리: 설정에 따라 유사 의미 단어 매칭 (“아이폰” ↔ “iPhone”, “휴대폰” ↔ “스마트폰”)
이렇게 분석된 단어들이 역색인 테이블에 저장되어 빠르게 검색이 가능합니다.
2. 준실시간 데이터 처리
대용량 로그 데이터나 실시간 스트리밍 데이터를 빠르게 색인하고 검색할 수 있습니다.
ELK 스택(Elasticsearch + Logstash + Kibana)과 함께 사용하여 실시간 모니터링과 분석이 가능합니다.
3. 수평 확장성
샤드(Shard)를 통한 데이터 분산 저장으로 서버를 추가하여 성능을 향상시킬 수 있습니다. 클러스터 구성으로 고가용성을 보장하며, 노드 장애 시에도 서비스 중단 없이 운영 가능합니다.
4. Schemaless
정형화되지 않은 문서도 자동으로 색인하고 검색할 수 있습니다. 미리 스키마를 정의하지 않고 동적으로 필드를 추가할 수 있습니다.
단점
1. 완전 실시간은 아님
색인된 데이터는 내부적으로 commit과 flush 같은 복잡한 과정을 거치기에, 약 1초 뒤에나 검색이 가능합니다.
2. 트랜잭션 롤백 지원 안함
전체적인 클러스터 성능 향상을 위해 비용이 큰 롤백, 트랜잭션을 지원하지 않습니다. 따라서 데이터 일관성이 중요한 작업에는 부적합 합니다.
3. 데이터 업데이트 비용이 높음
업데이트 명령이 올 경우 기존 문서 삭제 후 새로운 문서를 생성합니다.
일반적인 UPDATE에 비해 많은 비용이 들지만, 불변성이라는 이점을 갖게 됩니다. 자주 수정하는 데이터보다는 로그 같은 데이터에 적합합니다.
Elasticsearch 핵심 개념
Index
- 데이터 저장 공간으로 RDB의 Table에 대응
Shard
- 인덱스 내부의 데이터를 여러 개의 파티션으로 나눈 단위
- 분산 저장과 병렬 처리를 위해 사용
Document
- 데이터가 저장되는 최소 단위로, JSON 포맷으로 저장
- RDB의 Row에 대응
Field
- 문서를 구성하는 속성으로, RDB의 Column에 대응
- 하나의 필드는 목적에 따라 다수의 데이터 타입 가질 수 있음
Mapping
- 문서의 필드와 필드 속성을 정의하고, 색인 방법을 정의하는 프로세스
- RDB의 스키마와 유사하지만 더 유연
- 한 번 생성된 매핑 정보는 변경 불가
Master Node
- 클러스터 전체를 관리하는 노드
- 노드 추가/제거, 인덱스 생성/삭제 등의 클러스터 관리 작업 담당
Data Node
- 실제 데이터가 저장되는 노드로, 샤드가 배치됨
- 검색과 통계 등 데이터 관련 작업 수행하며, 가장 많은 리소스 사용
Coordinating Node
- 사용자의 요청을 받아 적절한 노드로 전달
- 클러스터 관련 요청은 마스터 노드로, 데이터 관련 요청은 데이터 노드로 라우팅
Ingest Node
- 문서의 전처리 담당
- 인덱스 생성 전에 문서의 형식을 변경 가능
클러스터 구조 예시
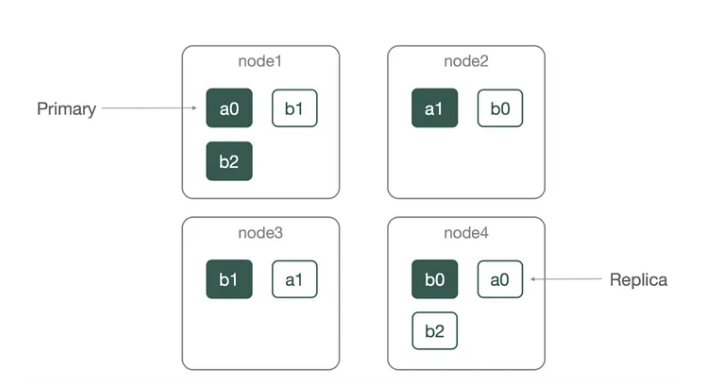
이 그림은 4개의 노드(node1~4)로 구성된 Elasticsearch 클러스터 입니다.
클러스터에는 **두 개의 인덱스(a, b)**가 있습니다.
- 인덱스 a: 2개의 샤드로 구성 (a0, a1)
모든 샤드는 Primary와 Replica을 가집니다.
- 인덱스 a의 경우
- a0 Primary는 node1에, a0 Replica는 node4에 위치
- a1 Primary는 node2에, a1 Replica는 node3에 위치
그림처럼 같은 샤드의 Primary와 Replica는 같은 노드에 두지 않습니다
RDB, Elasticsearch 구조 비교
| RDBMS | Elasticsearch | 설명 |
|---|---|---|
| Database | Cluster | 전체 데이터베이스 시스템 |
| Table | Index | 데이터가 저장되는 논리적 단위 |
| Row | Document | 하나의 데이터 레코드 |
| Column | Field | 데이터의 속성 |
| Schema | Mapping | 데이터 구조 정의 |
| SQL | Query DSL | 데이터 조회 언어 |
언제 Elasticsearch를 사용할까?
적합한 경우
- 전문검색: 제품 검색, 문서 검색, 콘텐츠 검색
- 로그 분석: 시스템 로그, 애플리케이션 로그 분석
- 실시간 분석: 사용자 행동 분석, 비즈니스 메트릭 분석
- 추천 시스템: 유사 상품, 관련 콘텐츠 추천
부적합한 경우
- 강한 일관성: 금융 거래, 재고 관리 등 ACID가 필요한 시스템
- 복잡한 관계: 다중 테이블 조인이 빈번한 시스템
- 단순 CRUD: 간단한 데이터 입출력만 필요한 경우
- 자주 수정되는 데이터: 업데이트 비용이 높아 비효율적
참고 자료