DuckDB의 개념 및 사용해보기
DuckDB의 개념 및 사용해보기
DuckDB란?
빠르고 효율적인 데이터 분석을 위해 설계된 강력한 인메모리 SQL 데이터베이스 엔진입니다. 서버-클라이언 모델(MySQL, PostgreSQL 등)과 달리 서버 없이 직접 애플리케이션에 내장되어 사용할 수 있습니다.
특징
1. 컬럼 기반 저장소
- 데이터를 컬럼 별로 따로 저장합니다. (기존 RDB는 행 별로 저장합니다.)
- 분석 쿼리는 보통 전체 행이 아닌 특정 컬럼들만 필요로 하기 때문에, 필요한 컬럼만 읽어 메모리 사용량과 I/O를 크게 줄일 수 있습니다.
- 동일 유형의 데이터가 모여 있어 압축률이 높아지고 메모리 효율이 향상됩니다.
2. 벡터화된 쿼리 처리
- 한 번에 여러 행을 벡터 or 배치 단위로 처리합니다.
- 벡터화된 처리는 연산 중 불필요한 함수 호출을 줄이고 CPU 캐시를 효율적으로 활용하여 복잡한 데이터 처리 속도를 향상시킵니다.
3. 파일 직접 쿼리
- CSV, Parquet 등 파일을 DB에 로드하지 않고 직접 SQL로 분석할 수 있습니다.
- 메모리 매핑기술을 사용해 파일을 메모리에 로드한 것처럼 접근할 수 있어, 대용량 파일도 효율적으로 처리합니다.
1
2
3
4
5
-- CSV 파일 직접 쿼리
SELECT AVG(salary) FROM read_csv('employees.csv');

-- Parquet 파일 직접 쿼리
SELECT COUNT(*) FROM read_parquet('sales.parquet') WHERE region='Asia';
활용 이점
- 코드 간소화: 복잡한 데이터 처리를 SQL로 간결하게 표현할 수 있습니다.
- 성능 향상: 메모리 사용량 감소, 처리 속도 향상으로 빠른 분석이 가능합니다.
- 쉬운 통합: 외부 종속성이 없으며 기존 애플리케이션과 완벽하게 통합됩니다.
주요 사용 사례
- 대용량 CSV/Parquet 파일 분석
- ETL 파이프라인의 변환(Transform) 단계
- 임시 분석(Ad-hoc analysis) 작업
Spring Boot에서 DuckDB 사용해보기
Hugging Face의 Parquet 파일을 직접 테이블로 가져와 확인해봅니다.
의존성 & 애플리케이션 설정 추가
1
implementation group: 'org.duckdb', name: 'duckdb_jdbc', version: '1.1.3'
1
2
3
4
spring:
  datasource:
    url: jdbc:duckdb:./data/myapp.duckdb
    driver-class-name: org.duckdb.DuckDBDriver
Config 구성
.duckdb 파일을 만들어주기 위한 Config를 설정합니다.
파일이 없을 경우 자동으로 생성해주고, 기존 파일이 있을 경우 그대로 사용합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
@Slf4j
@Configuration
public class DBConfig {

    @Value("${spring.datasource.url}")
    private String jdbcUrl;

    @Value("${spring.datasource.driver-class-name}")
    private String driverClassName;

    @Value("${spring.datasource.username:}")
    private String username;

    @Value("${spring.datasource.password:}")
    private String password;

    @Bean
    @Primary
    public DataSource duckDBDataSource() {
        initializeDuckDBFile();

        return DataSourceBuilder.create()
                .url(jdbcUrl)
                .driverClassName(driverClassName)
                .username(username)
                .password(password)
                .build();
    }

    private void initializeDuckDBFile() {
        try {
            String filePath = jdbcUrl.replace("jdbc:duckdb:", "");
            File dbFile = new File(filePath);

            if (!dbFile.exists()) {
                log.info("Initializing DuckDB file: {}", filePath);
                try (Connection conn = DriverManager.getConnection(jdbcUrl)) {
                    log.info("DuckDB file successfully initialized: {}", filePath);
                } catch (SQLException e) {
                    log.error("Error initializing DuckDB file: {}", e.getMessage());
                    throw new RuntimeException("Failed to initialize DuckDB file", e);
                }
            } else {
                log.info("Using existing DuckDB file: {}", filePath);
            }
        } catch (Exception e) {
            log.error("Failed to check DuckDB file", e);
            throw new RuntimeException(e);
        }
    }
}
Parquet 파일 import
read_parquet() 함수를 사용하여 Hugging Face 데이터셋의 Parquet 파일을 직접 읽어와 테이블로 변환합니다.
1
2
3
4
5
6
7
8
9
10
11
12
@Service
@RequiredArgsConstructor
public class DuckDBService {
    private final JdbcTemplate jdbcTemplate;
    private static final String PARQUET_FILE_PATH = "hf://datasets/OpenCo7/UpVoteWeb/data/merged_1.parquet";

    public void importParquetFile() {
        jdbcTemplate.execute("CREATE OR REPLACE TABLE reddit_comments AS SELECT * FROM read_parquet('" + PARQUET_FILE_PATH + "')");
    }

    // ...
}
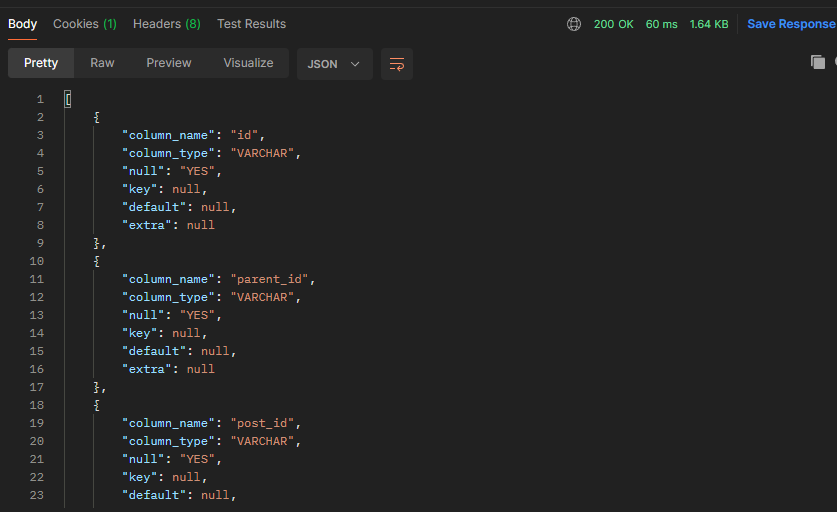
데이터 확인
가져온 테이블의 구조 및 데이터를 확인합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
@Service
@RequiredArgsConstructor
public class DuckDBService {
    private final JdbcTemplate jdbcTemplate;
    private static final String PARQUET_FILE_PATH = "hf://datasets/OpenCo7/UpVoteWeb/data/merged_1.parquet";

    public List<Map<String, Object>> describeTable(String tableName) {
        String query = "DESCRIBE SELECT * FROM " + tableName;
        return jdbcTemplate.queryForList(query);
    }

    public List<Map<String, Object>> getTableData(String tableName, int limit) {
        String query = "SELECT * FROM " + tableName + " LIMIT " + limit;
        return jdbcTemplate.queryForList(query);
    }
}
참고 자료
This post is licensed under CC BY 4.0 by the author.