PostgreSQL 파티셔닝 사용 및 성능 확인
파티셔닝이 왜 필요한가?
서비스 규모가 커질수록 데이터는 급격히 증가합니다. 단일 테이블에 수억 건 이상의 데이터를 계속 쌓게 되면 다음과 같은 문제가 발생합니다.
성능 저하 (Disk I/O 증가): 데이터와 인덱스 크기가 커지면서 메모리 용량을 초과하게 되면, 인덱스 탐색 시 디스크 I/O가 빈번해지며 조회 성능이 급격히 떨어집니다.
조회 효율 감소: 특정 key의 데이터만 필요한 상황임에도 불구하고, 전체 테이블을 스캔하거나 비대해진 인덱스를 탐색해야 하는 비효율이 발생합니다.
관리 및 운영 부담: 데이터를 삭제할 때 DELETE 명령은 대량의 트랜잭션 로그를 생성하고, 이후 VACUUM 부하와 Lock을 유발합니다.
이런 문제를 해결하기 위해 파티셔닝이 있습니다.
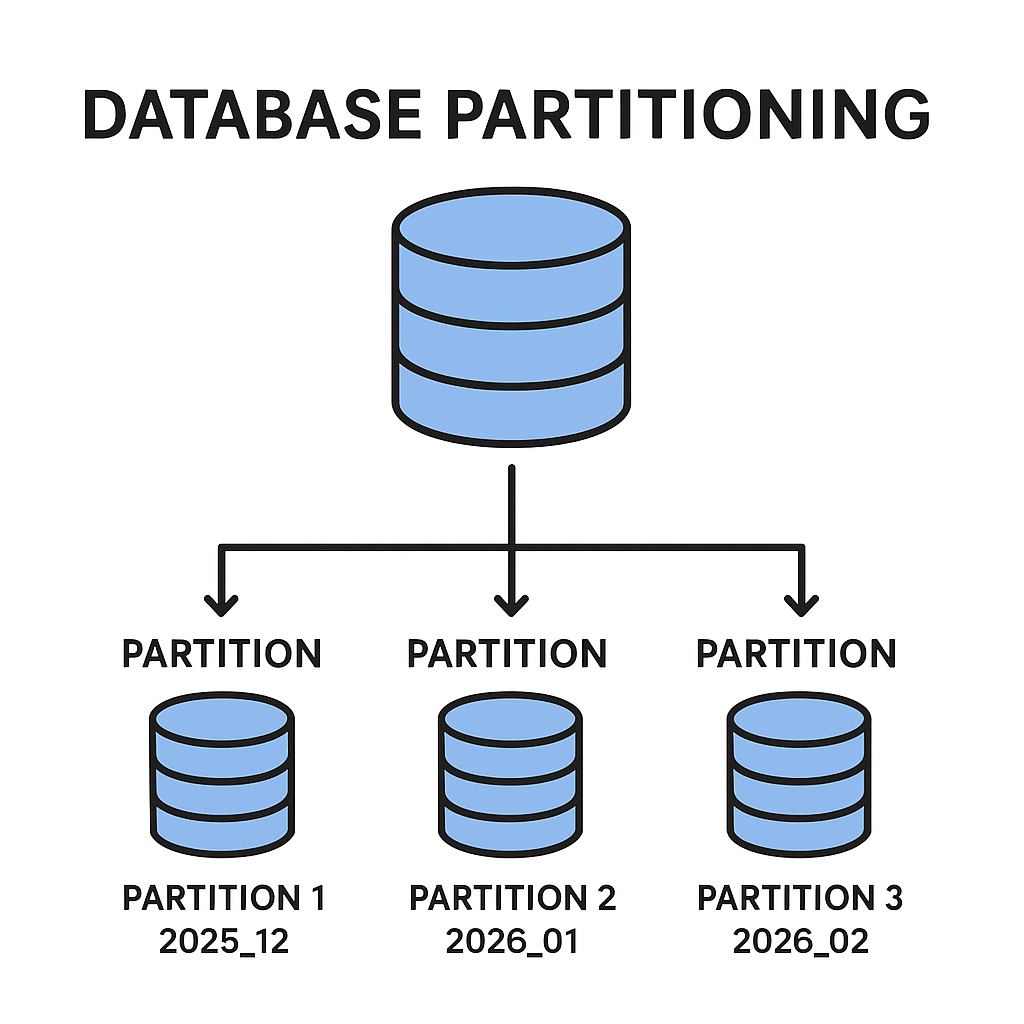
파티셔닝은 단일 테이블을 물리적으로 여러 개의 작은 테이블로 분할하여 관리하는 기법입니다.
논리적으로는 하나의 테이블처럼 보이지만, 실제 데이터는 정해진 규칙에 따라 독립된 공간에 나누어 저장됩니다.
PostgreSQL의 파티셔닝 방식
PostgreSQL은 세 가지 주요 파티셔닝 방식을 제공합니다.
Range Partitioning
특정 열의 값 범위를 기준으로 데이터를 나눕니다.
예시: created_at 컬럼을 기준으로 월별 파티션 생성 (2025_12, 2026_01 등)
특징:
- 로그 데이터, 시계열 데이터에서 흔히 사용됩니다.
- 날짜, 숫자 범위 등 연속적인 값을 가진 컬럼에 적합합니다.
List Partitioning
특정 키의 값 목록을 기준으로 분산합니다.
예시: 모델 식별자 값에 따라 파티션 생성 (Model_A, Model_B 등)
특징:
- 명확하게 구분되는 카테고리나 식별자가 있을 때 유리합니다.
- 지역 코드, 상태 값 등 이산적인 값에 적합합니다.
Hash Partitioning
특정 컬럼의 값을 해시 함수에 돌려 나온 결과에 따라 데이터를 균등하게 나눕니다.
특징:
- Range나 List처럼 명확한 기준은 없지만, 특정 파티션에 데이터가 몰리는 ‘Hot Spot’ 현상을 방지하고 부하를 균등하게 분산시키고 싶을 때 사용합니다.
- 파티션 개수를 지정하여 데이터를 균등 분산할 수 있습니다.
PostgreSQL 파티셔닝 예시
날짜 기준으로 특정 로그가 쌓이는 service_logs 테이블이 있습니다.
해당 테이블을 Range 기준으로 파티셔닝하는 예시입니다.
1. 부모 테이블 생성
먼저 부모 테이블을 생성합니다.
1
2
3
4
5
6
7
8
9
-- 부모 테이블 생성
CREATE TABLE service_logs (
    id BIGSERIAL,
    user_id INT,
    action TEXT,
    created_at TIMESTAMP WITHOUT TIME ZONE NOT NULL,
    -- 파티션 키(created_at)는 반드시 PK에 포함되어야함
    PRIMARY KEY (id, created_at)
) PARTITION BY RANGE (created_at);
2. 자식 파티션 테이블 생성
해당하는 자식 테이블들을 생성합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
-- 2025년 12월 데이터용 파티션
CREATE TABLE logs_2025_12
    PARTITION OF service_logs
    FOR VALUES FROM ('2025-12-01') TO ('2026-01-01');

-- 2026년 1월 데이터용 파티션
CREATE TABLE logs_2026_01
    PARTITION OF service_logs
    FOR VALUES FROM ('2026-01-01') TO ('2026-02-01');

-- 2026년 2월 데이터용 파티션
CREATE TABLE logs_2026_02
    PARTITION OF service_logs
    FOR VALUES FROM ('2026-02-01') TO ('2026-03-01');
3. 데이터 삽입 및 확인
데이터를 삽입하면 해당 range에 따라서 데이터가 들어가있는 것을 확인할 수 있습니다.
1
2
3
4
5
6
7
8
-- 2025년 12월 데이터 (logs_2025_12로 이동)
INSERT INTO service_logs (user_id, action, created_at) VALUES (101, 'login', '2025-12-15 10:00:00');
INSERT INTO service_logs (user_id, action, created_at) VALUES (102, 'view_page', '2025-12-31 23:59:59');

-- 2026년 1월 데이터 (logs_2026_01로 이동)
INSERT INTO service_logs (user_id, action, created_at) VALUES (201, 'login', '2026-01-01 00:00:01');
INSERT INTO service_logs (user_id, action, created_at) VALUES (202, 'purchase', '2026-01-15 14:20:00');
INSERT INTO service_logs (user_id, action, created_at) VALUES (203, 'logout', '2026-01-20 09:10:00');
1
SELECT * FROM logs_2025_12;
| id | user_id | action | created_at |
|---|---|---|---|
| 1 | 101 | login | 2025-12-15 10:00:00 |
| 2 | 102 | view_page | 2025-12-31 23:59:59 |
1
SELECT * FROM logs_2026_01;
| id | user_id | action | created_at |
|---|---|---|---|
| 3 | 201 | login | 2026-01-01 00:00:01 |
| 4 | 202 | purchase | 2026-01-15 14:20:00 |
| 5 | 203 | logout | 2026-01-20 09:10:00 |
단일 테이블 vs 파티셔닝 테이블 성능 비교
동일한 환경에서 20만 건의 데이터를 대상으로 조회 성능을 테스트한 결과, 파티셔닝 테이블이 단일 테이블 대비 약 18배 이상 빠른 성능을 보였습니다.
1. 단일 테이블 조회
1
2
3
4
EXPLAIN ANALYZE
SELECT * FROM service_logs_no_partition
WHERE created_at >= '2026-01-01' AND created_at < '2026-02-01'
  AND user_id = 101;
1
2
3
4
5
6
7
8
Gather  (cost=1000.00..4539.64 rows=98 width=28) (actual time=4.369..106.786 rows=105 loops=1)
  Workers Planned: 1
  Workers Launched: 1
  ->  Parallel Seq Scan on service_logs_no_partition  (cost=0.00..3529.84 rows=58 width=28) (actual time=2.025..4.869 rows=52 loops=2)
        Filter: ((created_at >= '2026-01-01 00:00:00'::timestamp without time zone) AND (created_at < '2026-02-01 00:00:00'::timestamp without time zone) AND (user_id = 101))
        Rows Removed by Filter: 99948
Planning Time: 0.072 ms
Execution Time: 106.807 ms
- 탐색 방식: Parallel Seq Scan (병렬 순차 스캔)
- 리소스 소모: 2개의 CPU 코어를 사용한 병렬 처리 시도
- 비효율성: 1월 데이터를 찾기 위해 전체 20만 건을 스캔한 후 필터링 (Rows Removed by Filter: 99,948)
- 실행 시간: 106.807 ms
2. 파티셔닝 테이블 조회
1
2
3
4
EXPLAIN ANALYZE
SELECT * FROM service_logs
WHERE created_at >= '2026-01-01' AND created_at < '2026-02-01'
  AND user_id = 101;
1
2
3
4
5
Seq Scan on logs_2026_01 service_logs  (cost=0.00..2574.02 rows=98 width=32) (actual time=0.136..5.892 rows=105 loops=1)
  Filter: ((created_at >= '2026-01-01 00:00:00'::timestamp without time zone) AND (created_at < '2026-02-01 00:00:00'::timestamp without time zone) AND (user_id = 101))
  Rows Removed by Filter: 99896
Planning Time: 0.174 ms
Execution Time: 5.909 ms
- 탐색 방식: Partition Pruning 적용 -
logs_2026_01파티션만 스캔 - 최적화: 쿼리 조건을 분석하여 해당 데이터가 없는 파티션은 아예 접근하지 않음
- 효율성: 병렬 처리 없이 단일 스캔으로 조회 완료, 불필요한 디스크 I/O 최소화
- 실행 시간: 5.909 ms
3. 성능 비교 요약
| 항목 | 단일 테이블 | 파티셔닝 테이블 | 개선율 |
|---|---|---|---|
| 실행 시간 | 106.807 ms | 5.909 ms | 18배 향상 |
| 스캔 범위 | 전체 20만 건 | 해당 파티션만 | Partition Pruning |
| CPU 사용 | 병렬 처리 (2 코어) | 단일 스캔 | 리소스 절약 |
파티셔닝 도입 시 운영 및 성능 이점
성능 최적화 (Partition Pruning): WHERE 절을 분석하여 필요한 파티션에만 접근하고 나머지는 스캔 대상에서 제외합니다. 이를 통해 불필요한 파티션 스캔을 방지하고 쿼리 성능을 크게 향상시킬 수 있습니다.
효율적인 데이터 삭제: 대량의 DELETE 문은 인덱스 재구성 및 VACUUM 부하를 유발합니다. 파티셔닝을 사용하면
DROP TABLE이나DETACH PARTITION명령으로 트랜잭션 로그 발생 없이 즉각적으로 대용량 공간을 확보할 수 있습니다.병렬 처리 향상: 각 파티션이 독립적으로 관리되므로, 여러 파티션에 대한 쿼리를 병렬로 실행할 수 있습니다.
인덱스 관리 효율성: 파티션별로 인덱스를 독립적으로 관리할 수 있어, 특정 파티션의 인덱스만 재구성하거나 최적화할 수 있습니다.
pg_partman으로 파티션 관리 자동화하기
pg_partman을 통해 파티션의 생성 및 삭제 등 생명 주기를 자동화할 수 있습니다. pg_partman은 예측 가능한 범위를 가진 Range Partitioning(날짜, 숫자 기반) 자동화에 최적화되어 있습니다.
1. pg_partman 설치 및 설정
관리용 스키마를 생성하고 모듈을 등록합니다.
1
2
CREATE SCHEMA partman;
CREATE EXTENSION pg_partman SCHEMA partman;
2. 파티션 자동 생성 설정
create_parent 함수를 실행하면 관리 설정이 등록되고, 설정 값에 따라 파티션 테이블이 자동으로 생성됩니다.
1
2
3
4
5
6
7
8
9
10
11
-- created_at 기준 월별 파티션
-- 미래 5개월을 미리 생성 + 12개월 이전 파티션은 자동 삭제
SELECT partman.create_parent(
    p_parent_table => 'public.service_logs',
    p_control => 'created_at',
    p_type => 'native',
    p_interval => 'monthly',
    p_premake => 5,
    p_retention => '12 months',
    p_retention_keep_table => false
);
| 파라미터 | 설명 |
|---|---|
p_parent_table | 파티셔닝을 적용할 부모 테이블 전체 경로 |
p_control | 파티션 기준 컬럼 (TIMESTAMP/DATE 또는 INTEGER/BIGINT) |
p_type | 파티셔닝 방식, 최신 PostgreSQL에서는 주로 native 사용 |
p_interval | 파티션 생성 주기 (daily, weekly, monthly, yearly) |
p_premake | 미리 생성해 둘 미래 파티션 개수 |
p_retention | 파티션 보관 기간 ('12 months', '90 days'..) |
p_retention_keep_table | true면 파티션만 분리, false면 테이블도 함께 삭제 |
3. 파티션 유지보수 실행
create_parent는 초기 설정만 등록할 뿐, 이후 자동으로 파티션을 생성하지 않습니다.
새로운 파티션 생성과 오래된 파티션 삭제를 위해서는 run_maintenance 함수를 주기적으로 실행해야 합니다.
1
SELECT partman.run_maintenance();
참고 자료